Wiem, wiem. W świecie AI miesiąc to dziś niemal epoka geologiczna, więc pisanie o GLM 5.2 może wydawać się nieco spóźnione. Mimo wszystko pożegnałem właśnie moją miesięczną subskrypcję Cursora i uznałem, że pora sprawdzić coś nowego. Wybór padł na Z.ai.
Miałem wobec niego spore oczekiwania. Korzystałem już wcześniej z modeli GLM - jeszcze w tych niemal mitycznych czasach, gdy miesięczna subskrypcja kosztowała około 3 dolarów, a flagowym modelem był GLM 4.7. To był grudzień 2025 roku. Sam model nie imponował może inteligencją na poziomie najlepszych konkurentów, ale oferował coś, czego dzisiejszy rynek wyraźnie nie lubi: praktycznie nieograniczone limity.
Przy typowej pracy programistycznej można było wręcz zapomnieć, że istnieją jakiekolwiek ograniczenia. Dobrze opisane zadanie, tryb planowania, ręczna weryfikacja planu, poprawki i na koniec polecenie „pracuj, dopóki nie skończysz” - wszystko działało bez konieczności ciągłego zerkania na licznik tokenów.
Dzisiaj sytuacja wygląda nieco inaczej. Według wielu osób śledzących branżę GLM 5.2 znajduje się tuż za ścisłą czołówką modeli programistycznych. Na podium najczęściej pojawiają się GPT-5.5 oraz Claude Opus, a zaraz za nimi wymieniany jest właśnie GLM. Niektórzy dodają jeszcze Fable 5, choć w chwili pisania tego tekstu model ten pozostaje niedostępny dla użytkowników.
Oficjalne benchmarki prezentują się następująco: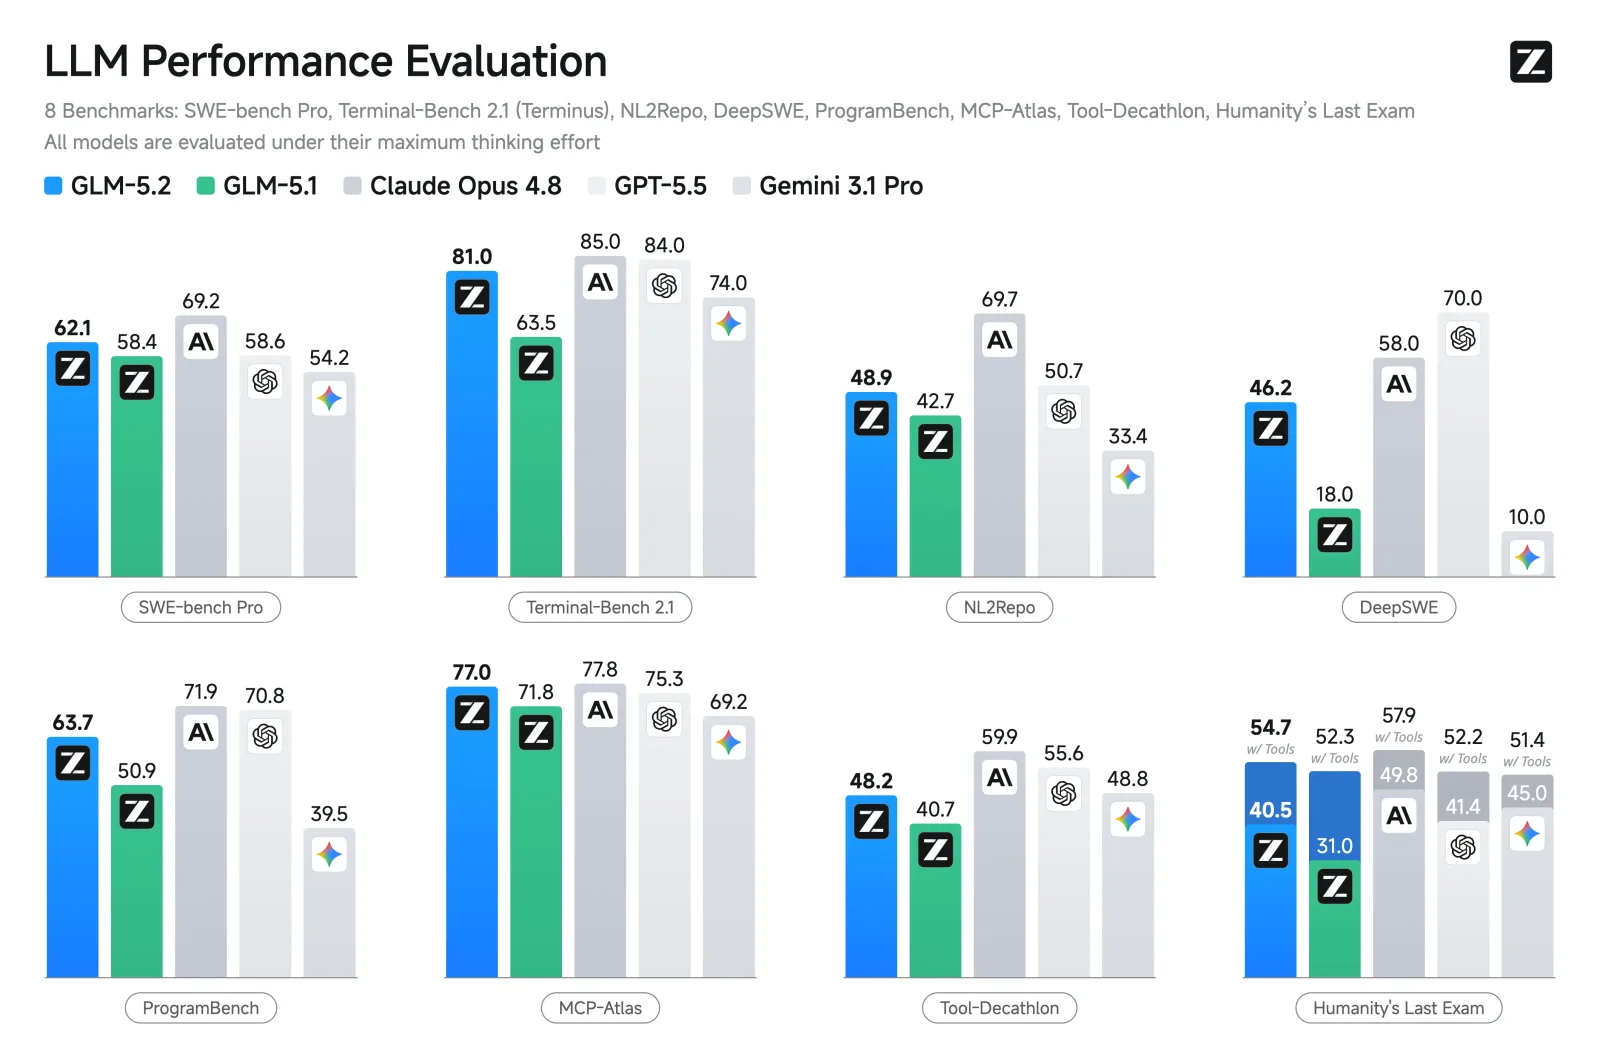
Najbardziej interesuje mnie obecnie wynik DeepSWE. Klasyczny SWE-Bench przestał być dla mnie szczególnie wiarygodny. Najnowsze modele były trenowane na tak ogromnych zbiorach danych, że istnieje duże prawdopodobieństwo, iż część z nich widziała już zadania lub rozwiązania wykorzystywane przez benchmark.
Nie przywiązuję też dużej wagi do osobowości modelu czy jego wiedzy ogólnej. Jeśli mam ochotę porozmawiać z czymś sztucznym i inteligentnym, ale faktycznie błyskotliwym, wybiorę Claude Opus. Do prostych pytań wystarczy zwykły gpt. Tutaj interesuje mnie przede wszystkim jedno: programowanie.
I właśnie pod tym kątem postanowiłem ocenić GLM 5.2.
Cała historia zaczęła się o dziewiątej rano. Wykupiłem subskrypcję, otworzyłem OpenCode i przygotowałem zadanie testowe. Od pewnego czasu „vibe-coduję” prywatną aplikację dla mnie i mojej dziewczyny. Backend w Symfony, frontend we Flutterze. Nic wielkiego, raczej niewielki projekt niż korporacyjny potwór.
Idealny kandydat do testów.
Miałem gotowe MVP w Markdownie oraz opisane konwencje projektowe. W poprzednim miesiącu podobne zadania wykonywałem przy pomocy Cursora. Cały proces zwykle sprowadzał się do dwóch promptów.
Pierwszy brzmiał mniej więcej tak:
„Przeanalizuj projekt, sprawdź czego brakuje względem MVP, wybierz sensowny zakres prac i zaimplementuj go.”
Drugi:
„Zrób code review własnych zmian, popraw znalezione problemy, uprość kod tam, gdzie się da, a następnie wykonaj commit i push.”
Bez filozofii.
Trzydzieści minut później zadanie nadal nie było ukończone. Co gorsza, większość tego czasu OpenCode spędził na oczekiwaniu na dostępność modelu. Komunikaty o przeciążeniu serwerów pojawiały się praktycznie bez przerwy. Trudno się dziwić — dla Chin był to środek dnia.
Skończył się za to mój pięciogodzinny limit tokenów.
Nie zadanie. Tokeny.
Ostatecznie poprosiłem GPT o dokończenie pracy, bo nie miałem ochoty czekać kolejnych czterech i pół godziny na odnowienie limitu.
Rozumiem ekonomię współczesnego AI. Rozumiem, że subsydiowanie użytkowników nie może trwać wiecznie. Problem polega na tym, że w planie za 20 dolarów zarówno Codex, jak i Claude oferują dziś limity wyraźnie większe.
Panel zużycia pokazał około 5,3 miliona tokenów. Początkowo wyglądało to fatalnie, ale później przypomniałem sobie o jednym szczególe: w godzinach szczytu wykorzystanie liczone jest potrójnie. Po południu, w naszej strefie czasowej, obowiązuje już mnożnik x1. Realnie oznaczałoby to około 15 milionów tokenów.
Brzmi znacznie lepiej.
Warto jednak pamiętać, że tygodniowy limit obejmuje dokładnie pięć takich pięciogodzinnych okien. W praktyce daje to około 75 milionów tokenów tygodniowo - pod warunkiem, że korzystamy z usługi poza godzinami największego obciążenia.
Ale dość o limitach.
Najważniejsze pytanie brzmi: czy GLM 5.2 faktycznie jest tak dobry, jak twierdzą benchmarki?
Krótka odpowiedź brzmi: tak.
GLM 5.2 to naprawdę znakomity model. Zwłaszcza jeśli pamiętamy, że mówimy o modelu open-weight. Pracując równolegle z nim oraz z Claude Opus 4.8 i porównując wyniki na tych samych zadaniach, bardzo często otrzymywałem efekty zaskakująco podobnej jakości.
Nie oznacza to oczywiście, że są to modele identyczne. Każdy ma własny styl rozwiązywania problemów, inne mocne strony i inne słabości. Różnica polega na tym, że GLM osiągnął już poziom, który jeszcze niedawno był zarezerwowany wyłącznie dla absolutnej czołówki. Potrafi samodzielnie analizować projekt, planować kolejne kroki i realizować całkiem duże fragmenty pracy bez konieczności prowadzenia go za rękę.
To już jest poziom współczesnego SOTA.
Szkoda tylko, że całość zamknięto w dość niewygodnym ekosystemie.
Największym problemem nie jest nawet sam model, lecz wszystko, co go otacza. Limity w podstawowym planie są dość skromne, dostępność API pozostawia wiele do życzenia, a komunikaty o przeciążeniu serwerów pojawiają się zdecydowanie zbyt często. Do tego dochodzi kwestia prywatności danych. Nie twierdzę, że jest źle — po prostu trudno dziś jednoznacznie ocenić, jakie gwarancje faktycznie otrzymuje użytkownik.
Owszem, większość tych problemów znika po wykupieniu wyższego planu. Tyle że wtedy pojawia się inne pytanie.
Jeżeli mam do wyboru wydać około 70 dolarów miesięcznie na Z.ai albo około 100 dolarów na Anthropic, prawdopodobnie wybrałbym tę drugą opcję. Jest drożej, ale w zamian otrzymujemy wyższe limity, stabilniejszą infrastrukturę i większe zaufanie do całego ekosystemu. Oczywiście ani Anthropic, ani OpenAI nie są wzorem idealnej prywatności, jednak pod tym względem budzą mimo wszystko większe zaufanie.
To jednak nie oznacza, że GLM 5.2 nie ma własnej, bardzo mocnej przewagi.
Wręcz przeciwnie.
Najciekawszy scenariusz zaczyna się tam, gdzie kończą się usługi chmurowe. Firmy dysponujące odpowiednim sprzętem mogą uruchomić model całkowicie lokalnie. Mówimy oczywiście o naprawdę potężnej infrastrukturze — około 1,5 TB pamięci VRAM — ale w zamian otrzymujemy rozwiązanie działające we własnym środowisku, bez wysyłania kodu czy dokumentacji do zewnętrznych dostawców.
Jeszcze kilka lat temu możliwość posiadania modelu tej klasy we własnym centrum danych wydawała się czymś kompletnie nierealnym.
Dzisiaj jest to po prostu jedna z dostępnych opcji.
I właśnie to uważam za największą zaletę GLM 5.2. Nie to, że jest minimalnie lepszy czy gorszy od któregoś z konkurentów, lecz to, że przenosi możliwości najnowszej generacji modeli AI poza zamknięte platformy największych firm.
Mam tylko jedną nadzieję.
Że wraz z kolejnymi generacjami nie znikną całkowicie modele ze średniej półki. Jeszcze niedawno otrzymywaliśmy świetne konstrukcje klasy około 100 miliardów parametrów, które dało się uruchomić na sprzęcie dostępnym dla entuzjastów. Dzisiaj coraz częściej rozwój koncentruje się wyłącznie na największych modelach wymagających infrastruktury dostępnej właściwie tylko dla dużych organizacji.
Szkoda, bo właśnie te mniejsze modele były dla wielu osób przepustką do świata lokalnej sztucznej inteligencji.
Ale to już temat na osobny wpis.
Dzięki za przeczytanie.