Żyjemy w ciekawych czasach.
Dwudziestego czwartego lipca Anthropic wypuścił Opusa 5. To ostatni model piątej serii - i zanim ktoś zaprotestuje: tak, formalnie istnieje jeszcze Haiku.
Tylko że jego istnienie przypomina raczej błąd przyrody.
Wystarczy wejść na Artificial Analysis i wybrać cztery modele do porównania. Świeżą Lune w wersji medium, V4 Flash od DeepSeeka, dla równowagi Mimo v2.5 Pro od Xiaomi - i Haiku. Okaże się, że pozostała trójka jest jednocześnie mądrzejsza, szybsza i tańsza.
Jednocześnie. To jest w tym wszystkim najciekawsze.
Zwykle wybór modelu polega na kompromisie. Coś jest szybkie, ale głupsze. Coś jest mądre, ale kosztuje. Coś jest tanie, ale trzeba je prowadzić za rękę. Tutaj kompromisu nie ma, bo nie ma żadnej osi, na której Haiku wygrywa. Naprawdę nie wiem, w jakiej jaskini trzeba żyć, żeby wydawało się rozsądnym wyborem do czegokolwiek.
Ciekawsze jest jednak coś innego. Anthropic do dziś nie potrafi znaleźć sensownego zastosowania dla Sonneta po jego ponownym wydaniu. Model, który jeszcze niedawno był domyślnym wyborem dla większości użytkowników, dziś funkcjonuje raczej jako pozycja w cenniku niż odpowiedź na jakiekolwiek konkretne pytanie.
Jeśli tak wygląda sytuacja modelu ze środka stawki, to wymyślenie niszy dla ewentualnego Haiku 5 będzie zadaniem jeszcze trudniejszym.
Ale dość dygresji.
Wracajmy do Opusa.
Tutaj zmieniło się naprawdę wiele. Opus 5 to ewidentnie pierwszy Opus, który nie powstał od podstaw, lecz przez destylację swojego większego brata - Mythosa.
Warto się przy tym na moment zatrzymać, bo to zmiana w samej konstrukcji oferty. Do tej pory Opus był tym, co firma miała najlepszego. Teraz najlepsze, co firma ma, jest przede wszystkim nauczycielem. Produktem, który dostajemy do ręki, jest uczeń.
Nie mówię tego jako zarzut. Wynik obronił się w praktyce.
Zmieniło się także pozycjonowanie. Oficjalnie mamy do czynienia z, cytując, „modelem do codziennej pracy". I to kolejny ukłon w stronę nowego podejścia Anthropica. Kiedyś rolę modelu na co dzień pełnił Sonnet, a Opus był drogi i mało kto go w ogóle używał - sięgało się po niego wtedy, gdy coś naprawdę się wywalało. Dziś to podstawowa opcja, do której sama firma zachęca w pierwszej kolejności.
Oficjalne benchmarki prezentują się następująco:
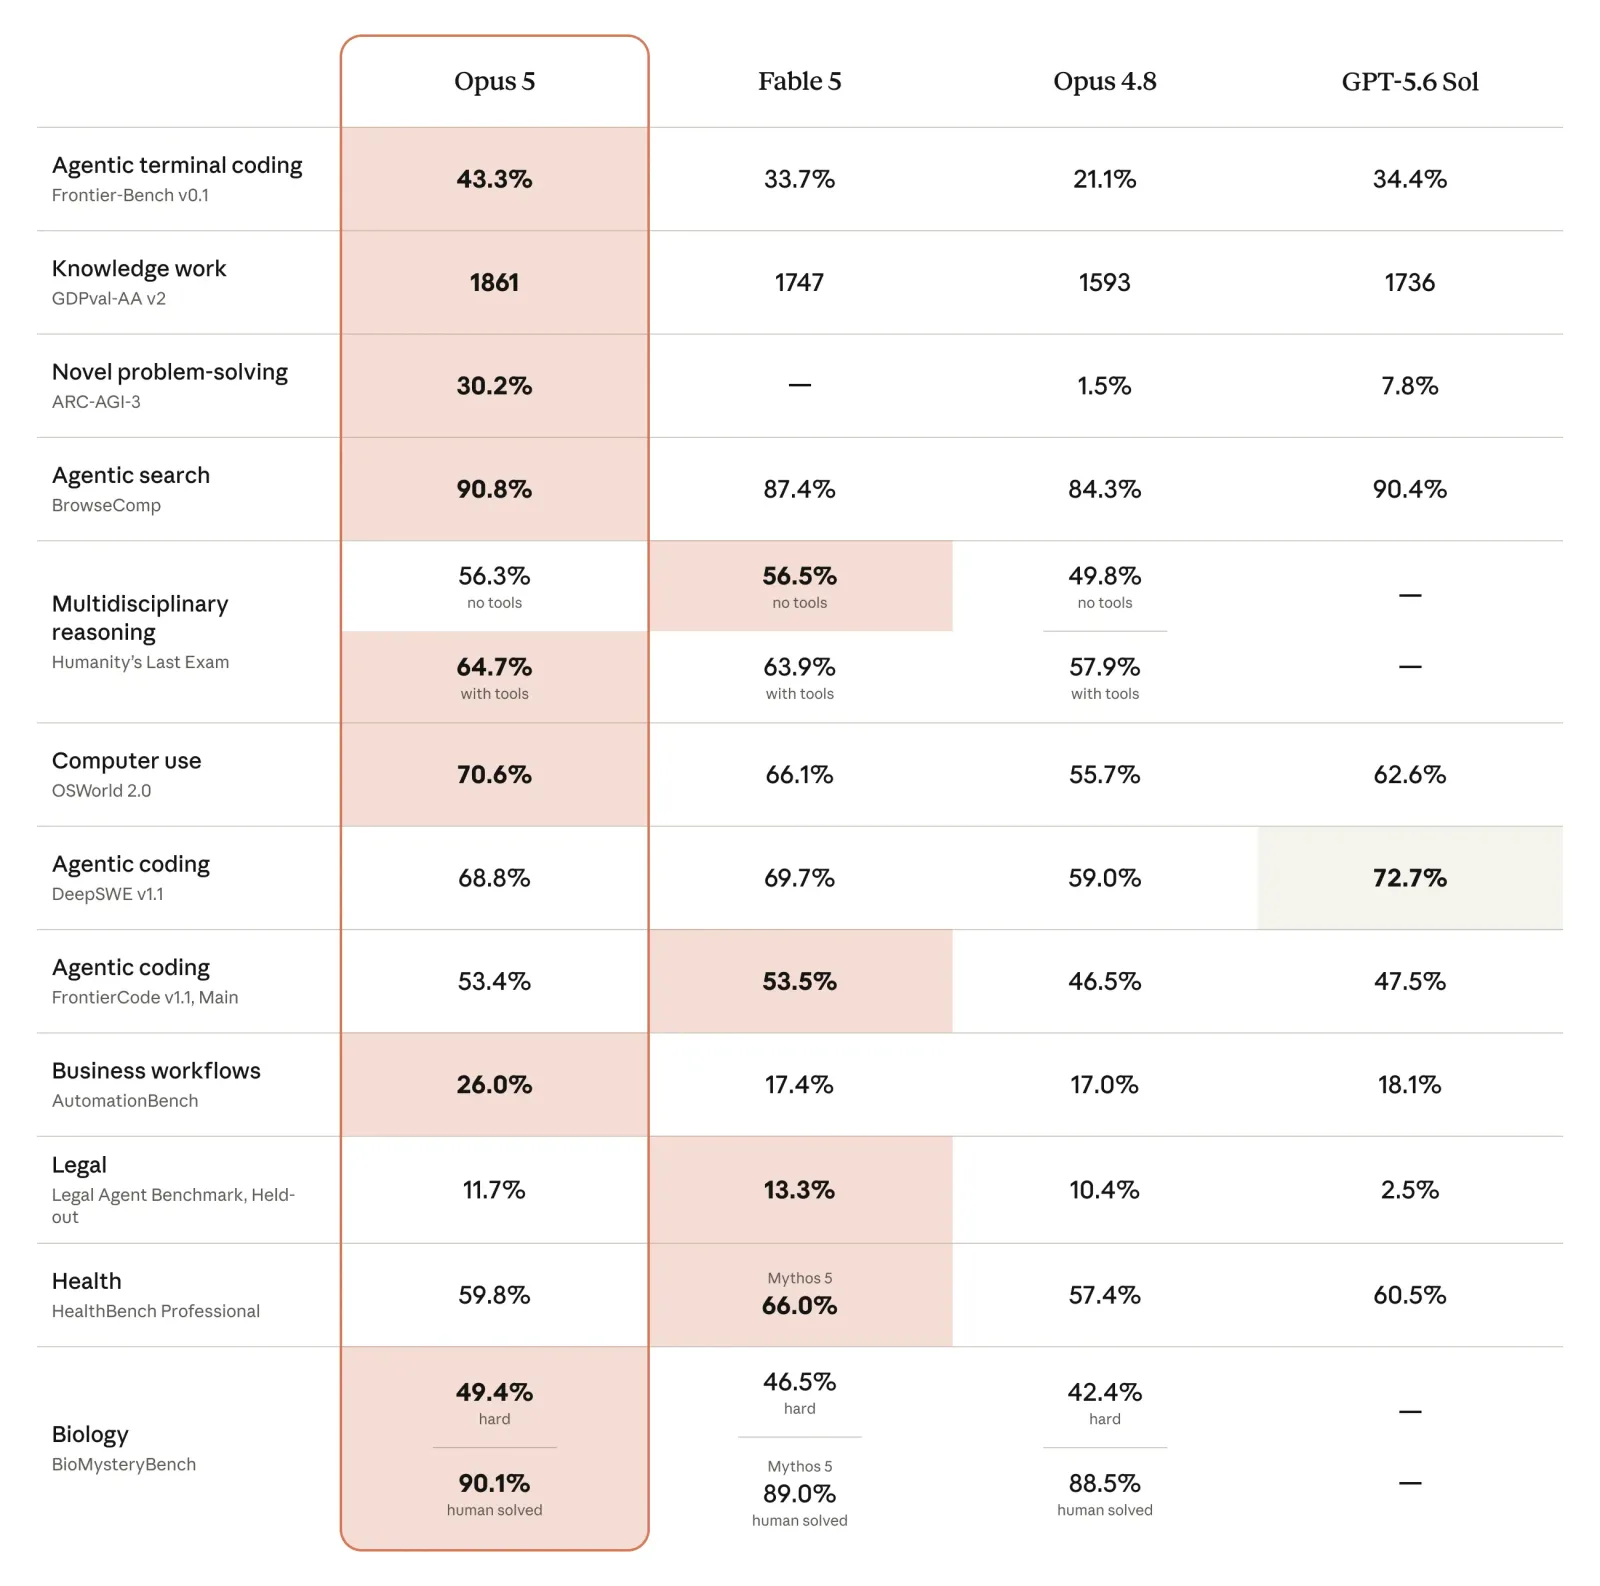
(zdjęcie z oficjalnego release note od Anthropic https://www.anthropic.com/news/claude-opus-5)
Na papierze wychodzi z tego model lepszy od Fable 5 w większości zastosowań.
Uwagę przyciąga natomiast rozjazd między materiałami Anthropica a wynikami DeepSWE. W DeepSWE Opus pokonuje większego brata i to całkiem wyraźnie: 74% do 70%. W oficjalnym porównaniu przegrywa - 68,8% do 69,7%.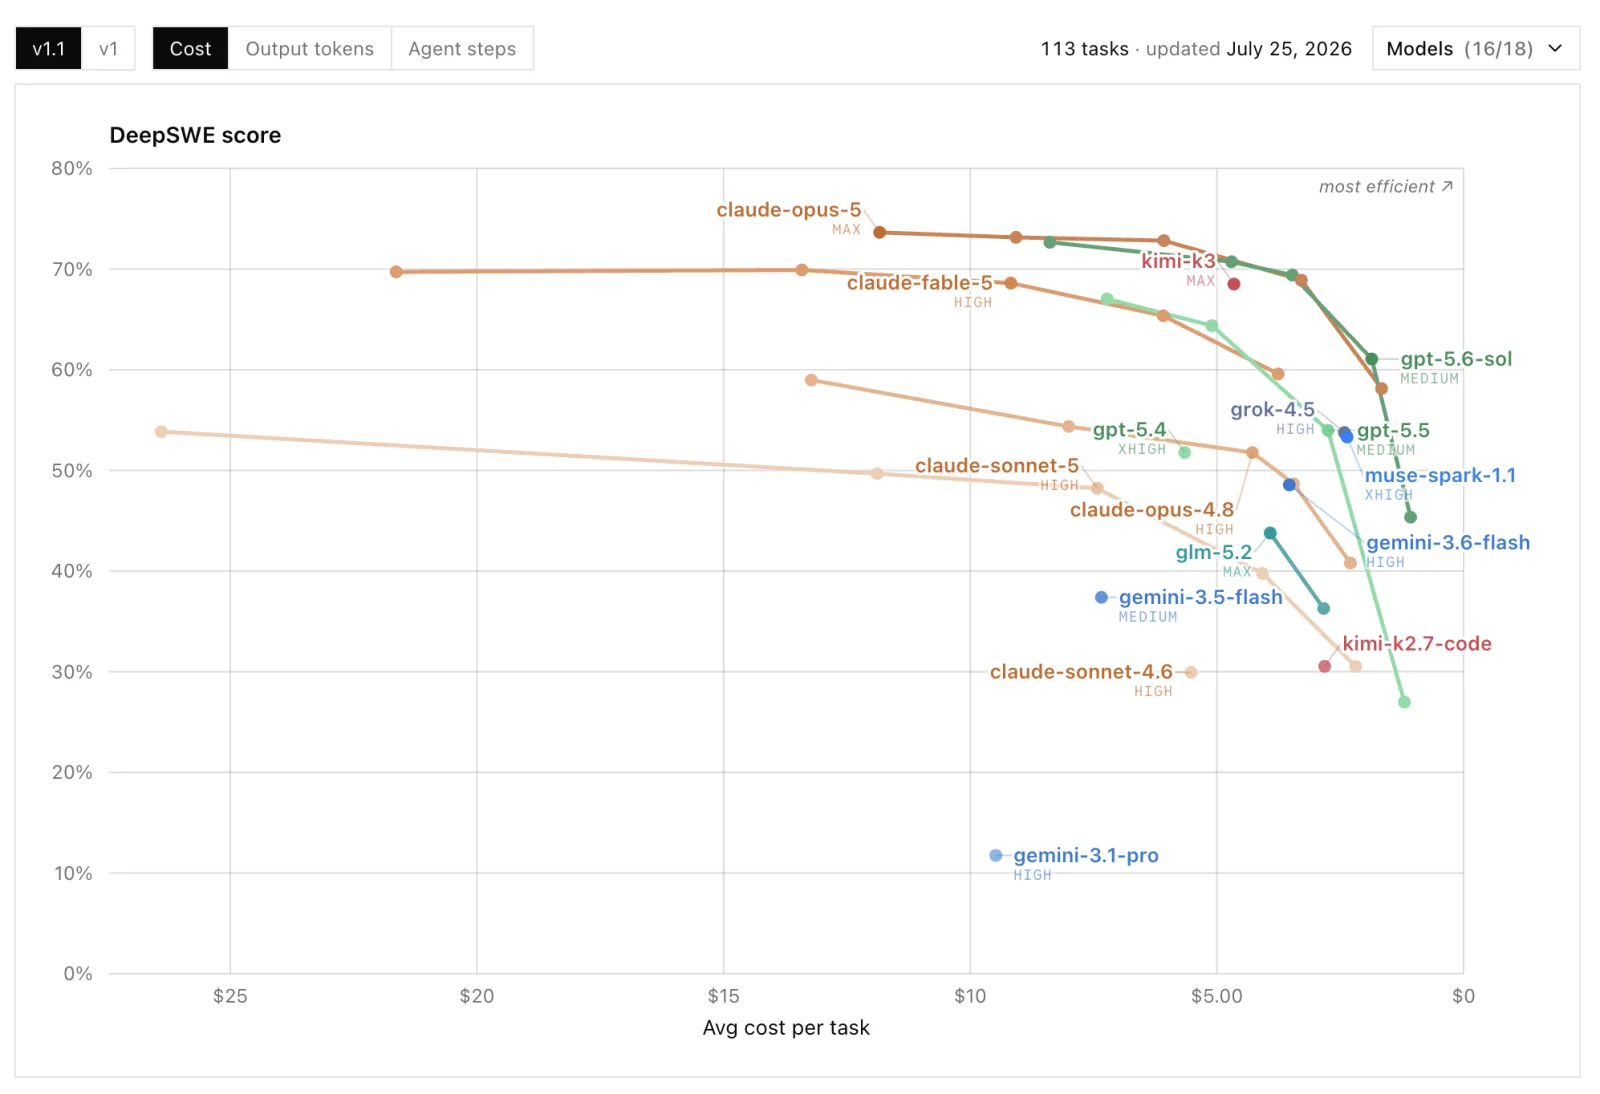
(wynniki z https://deepswe.datacurve.ai/)
Pisałem już kiedyś, że przywiązuję dziś większą wagę do DeepSWE niż do klasycznego SWE-Bencha, bo przy dzisiejszych zbiorach treningowych trudno mieć pewność, czego model nie widział na oczy. Ten przypadek dobrze pokazuje, dlaczego w ogóle warto sprawdzać kilka źródeł. Mamy dwa pomiary tej samej pary modeli, rozjeżdżające się o kilka punktów - i to w przeciwne strony.
Nie twierdzę, że ktoś tu naciąga wyniki. Twierdzę tylko, że różnica jednego punktu procentowego w oficjalnej tabelce nie mówi nam praktycznie nic o tym, jak model zachowa się w naszym projekcie.
Od dawna uważam natomiast, że najlepszym rozmówcą do omawiania życia jest Opus. Piątka nie jest tu wyjątkiem.
To fantastyczny partner do rozmowy na dowolny temat, który po prostu chcemy z kimś przegadać. Jest przy tym idealnym lizusem - lepszego ten świat chyba nie zna. Będzie mówić tak, jak chcesz, i tak, jak ty mówisz do niego. Kameleon i znawca wszystkiego.
I bardzo mi się podoba, że przy okazji nowego wydania tego nie zepsuto. Był dziwny moment w okolicach wersji 4.5 i 4.6 - dwa Opusy, które zachowywały się jak większe roboty niż rozmówcy. Potem sytuacja się poprawiła i na razie trzyma poziom.
Ale wróćmy do pracy.
Opus jest dla mnie czymś pomiędzy Solem a Fablem.
Te dwa modele psują się bowiem na dwa różne sposoby, a Opus siedzi wygodnie pomiędzy nimi.
Kod pisany przez Sola jest... hmm... maszynowy? Jakkolwiek to zabrzmi.
Będzie poprawny. Będzie przynajmniej na papierze spełniał wszystkie zasady z AGENTS.md. Ale kiedy się go czyta, zawsze okazuje się, że jest go po prostu za dużo, i zawsze trafia się kilka miejsc, w których pytasz: „ej, a po cholerę zrobiłeś to w taki sposób?".
To zresztą rzecz, której żaden benchmark nie mierzy. Test przechodzi albo nie przechodzi. Nikt nie punktuje tego, ile trzeba potem posprzątać.
Fable psuł się z drugiej strony. Był powolny i uparty. Robił zbyt wiele po swojemu i - tradycyjnie już dla modeli Anthropica - uważał, że wie lepiej, niż go prosiłeś. Efekt bywał dobry, ale często obok tego, o co pytałeś.
Opus ma tę tendencję rażąco mniejszą. To, co zostaje po jego pracy, wygląda po prostu „merdżowalniej" i częściej nadaje się do projektu od razu.
I to jest dla mnie właściwa miara. Nie procent na wykresie, a odpowiedź na pytanie, ile z wygenerowanej zmiany faktycznie zostaje w repozytorium po code review.
Zostaje jeszcze kwestia ceny.
Fable dzięki Kimi K3 został z nami, ale wyłącznie w planach Max x5 i x20. Dla biednych ludzi w rodzaju autora, czyli abonentów planu za 20 dolarów, pozostaje rozliczanie za tokeny, co czyni ten model niezbyt dostępnym.
Do tego Fable nadal zużywa tygodniowy limit dwa razy szybciej niż Opus. W praktyce oznacza to, że nawet mając do niego dostęp, dostajemy w ramach tego samego planu połowę pracy. A jak wynika z tabelek wyżej, różnica w jakości nie jest dwukrotna. Nie jest nawet blisko.
Najlepszy stosunek liczby tokenów do limitów to zatem wciąż Opus. W gratisie dochodzi jeszcze prędkość pracy - a to przy zadaniach agentowych bywa ważniejsze, niż się wydaje, bo model, który kończy szybciej, po prostu pozwala zrobić więcej podejść.
Generalnie ten model pozostawia przyjemny posmak. Tak to chyba można ująć najkrócej.
Szkoda tylko, że w praktyce pozostaje ograniczony do Claude Code. Ale cóż - nie wszystko naraz.
Dzięki za przeczytanie.